YOLO 多任务体验
📌 关键要点
一个 YOLO 框架能同时做 6 类任务:
detect(检测)、classify(分类)、segment(分割)、pose(姿态)、obb(旋转框)、semantic(语义分割,YOLO26 新增)。
- 本次用同一张鸟图(
bird_001.jpg)跑完 5 个任务,直观对比输出形态差异- 框 vs 标签 vs 掩码 vs 关键点 vs 旋转框,一目了然
- 结论先行:任务越精细越慢;模型只认它训练过的类别
一、实验背景与目的
在 YOLO简介 中认识了 YOLO 后,想更直观地感受"一个框架多个任务"的能力,于是做了本次实验:
- 用同一张输入图跑不同任务,对比它们各自输出什么
- 顺便测试非检测类任务(pose / obb)需要的输入类型不同(有人体的图 / 航拍图)
- 为后续潮间带范围识别(segment 方向)做技术摸底
二、实验环境
| 项目 | 内容 |
|---|---|
| 框架 | Ultralytics 8.4.60 |
| Python / 框架 | Python 3.12.11 / PyTorch 2.12.0+cpu |
| 硬件 | CPU(13th Gen Intel Core i9-13900H) |
| 工作目录 | ...\attachments\topic\Yolo\test\coco |
| 测试数据 | bird_001.jpg(鸟)+ COCO128(128张日常图)+ DOTA8(8张航拍图) |
💡 所有模型(约 6MB 一个)已下载到
test\coco\目录,之后可离线复用。数据集配置文件说明见 YOLO 数据集配置文件详解。
三、五个任务实验记录
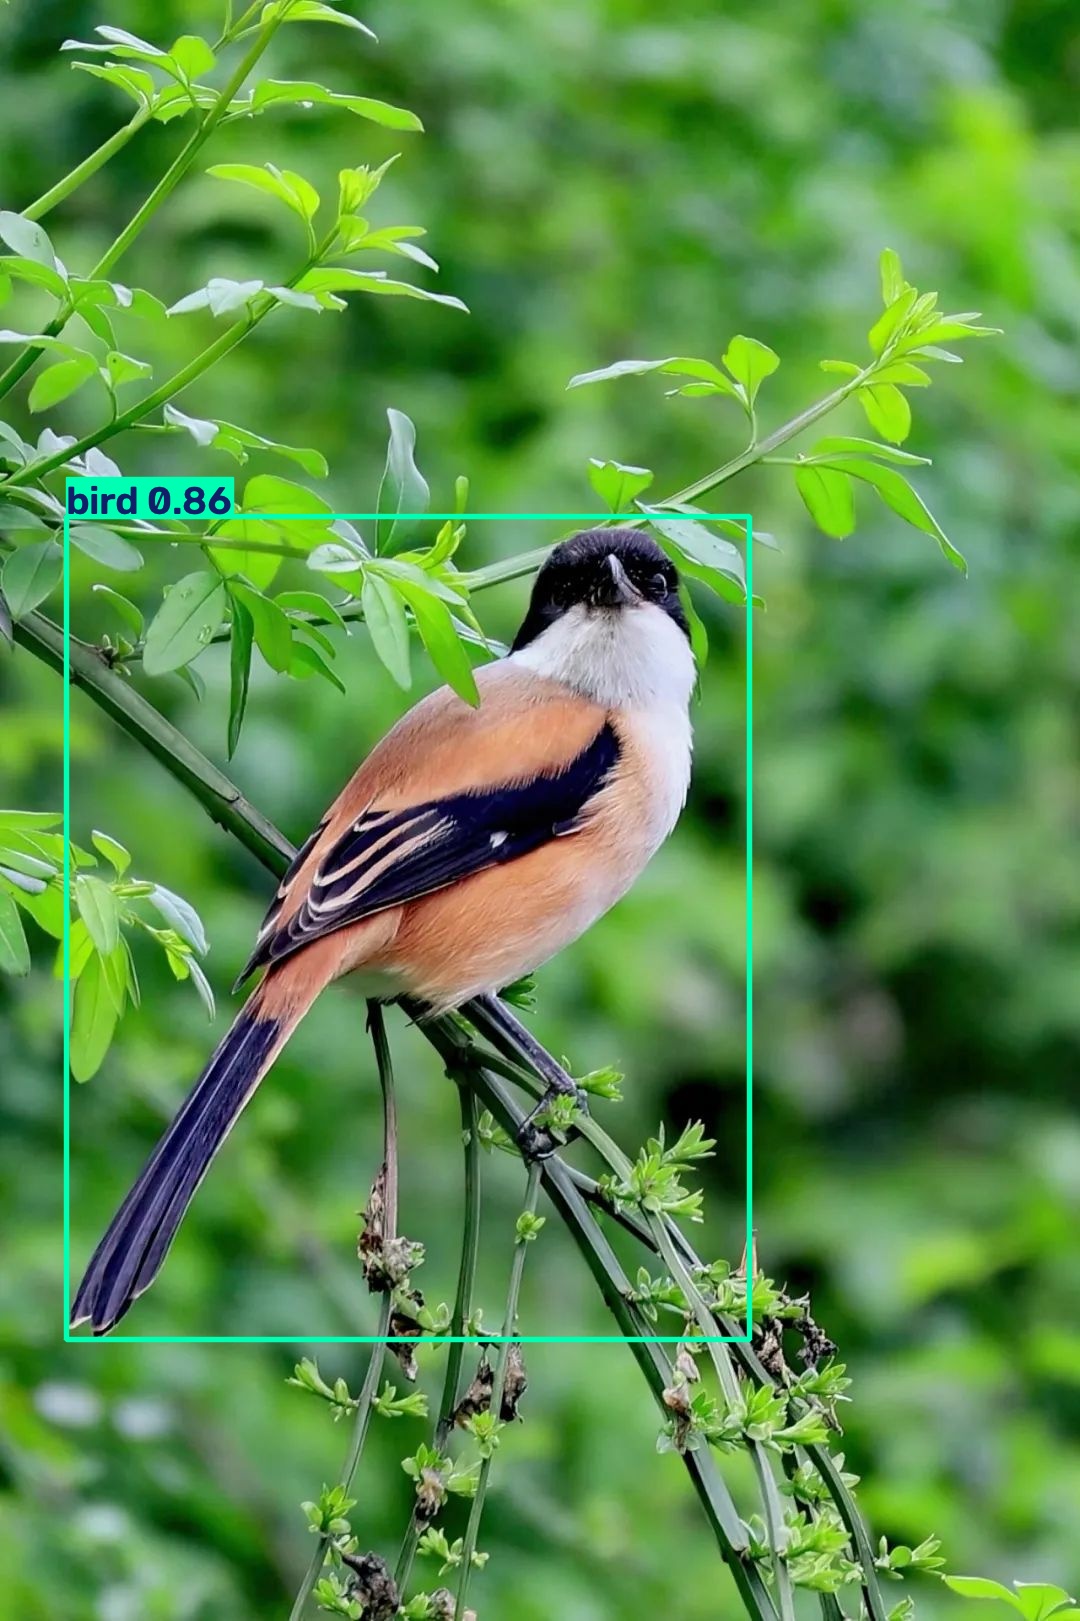
任务1️⃣ detect 目标检测(yolov8n.pt)
yolo predict model=yolov8n.pt source=bird_001.jpg project=runs/demo/01-detect
输出:640x448 1 bird, 73.8ms —— 画一个矩形框框住鸟,标注类别名 bird 和置信度。
任务2️⃣ classify 图像分类(yolov8n-cls.pt)
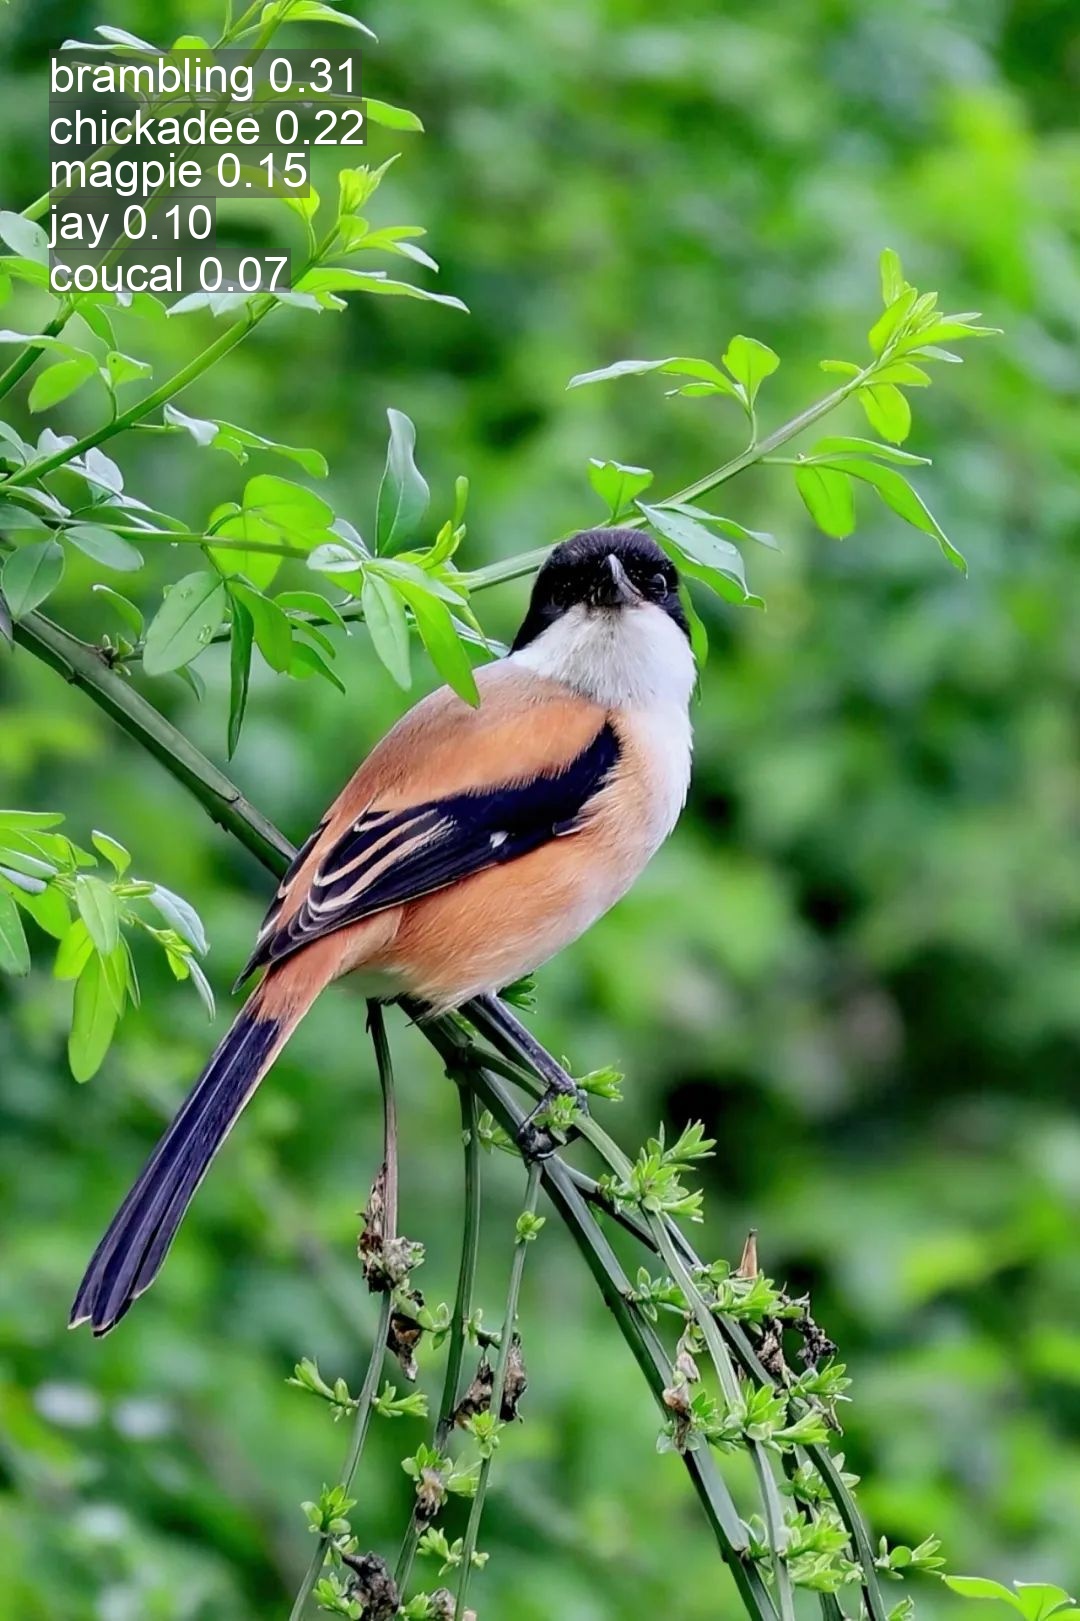
yolo predict model=yolov8n-cls.pt source=bird_001.jpg project=runs/demo/02-classify
输出:224x224 brambling 0.31, chickadee 0.22, magpie 0.15, jay 0.10, coucal 0.07, 14.4ms —— 不画框,直接给"这张图是什么"的 Top-5 概率(最可能是燕雀 brambling,31%)。
任务3️⃣ segment 实例分割(yolov8n-seg.pt)
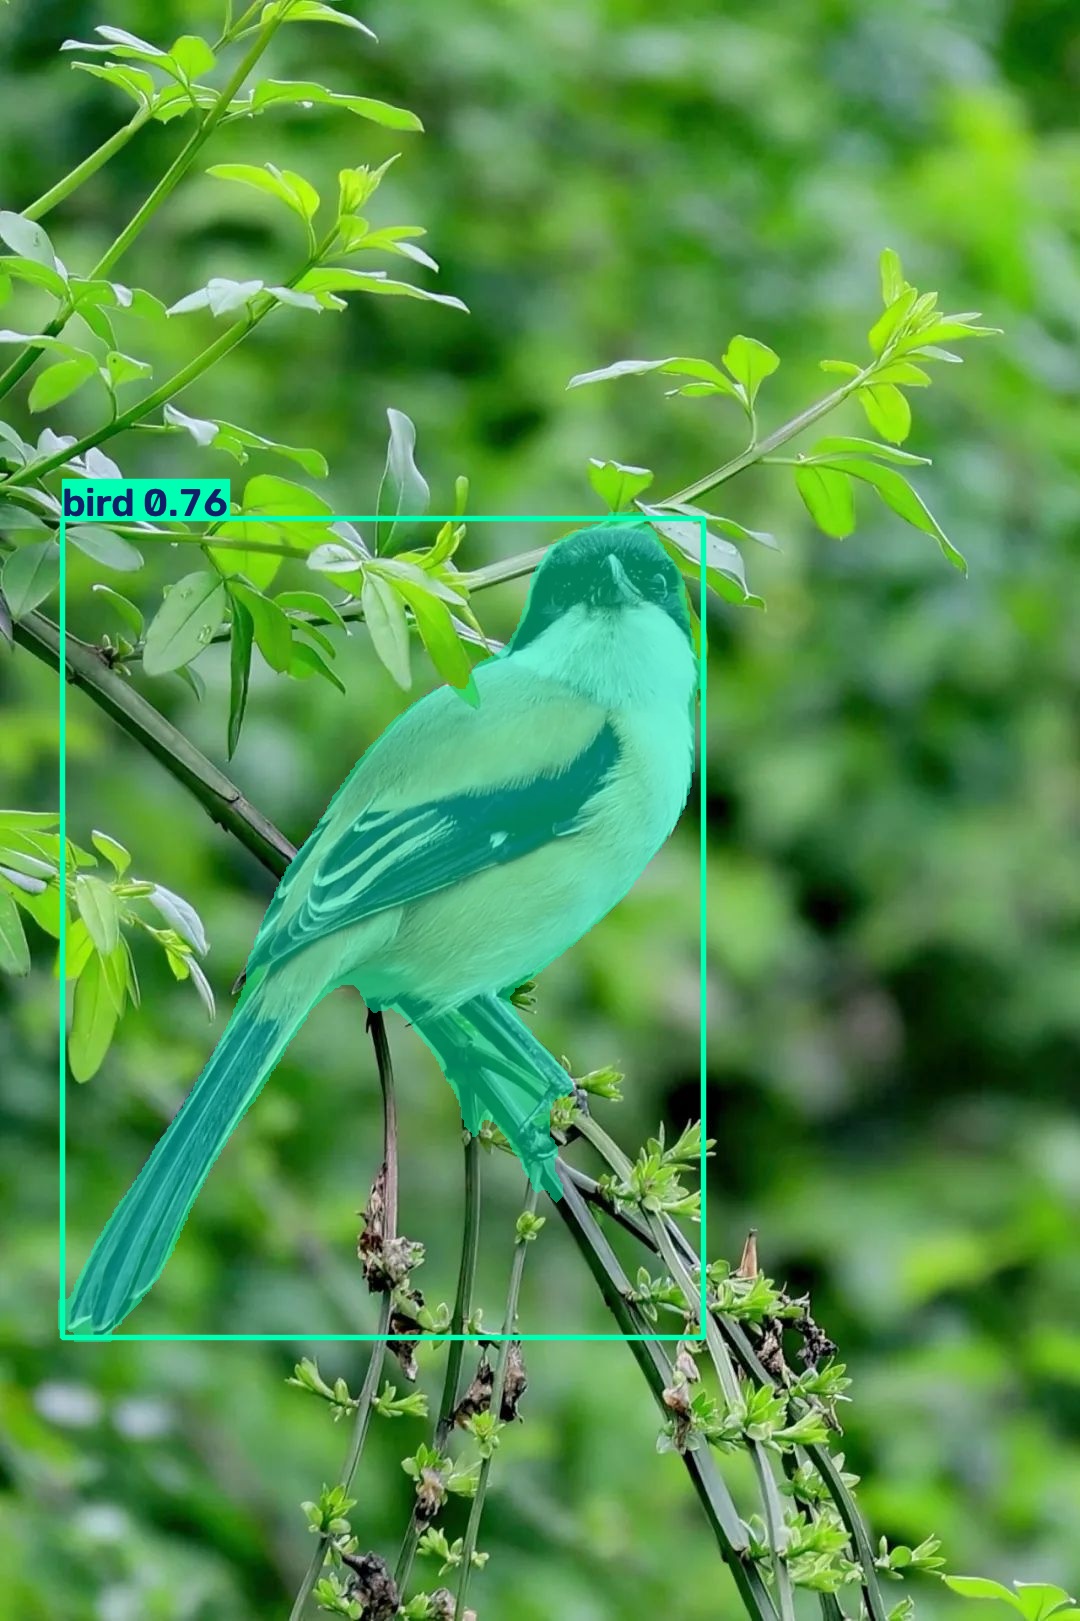
yolo predict model=yolov8n-seg.pt source=bird_001.jpg project=runs/demo/03-segment
输出:640x448 1 bird, 81.9ms —— 不仅画框,还沿着鸟的轮廓抠出像素掩码(半透明蒙版盖住整个鸟身)。
任务4️⃣ pose 姿态估计(yolov8n-pose.pt)
yolo predict model=yolov8n-pose.pt source=coco128/images/train2017 project=runs/pose/runs/demo/04-pose conf=0.25
输出:对 128 张 COCO128 图全部推理,其中 4 张检出人体,其余 no detections —— 说明 pose 模型只认 person(对鸟完全无响应)。平均推理 47.6ms/张。
检出人体的图:000000000036(1人)、000000000623(2人)、000000000625(3人)、000000000634(2人)。
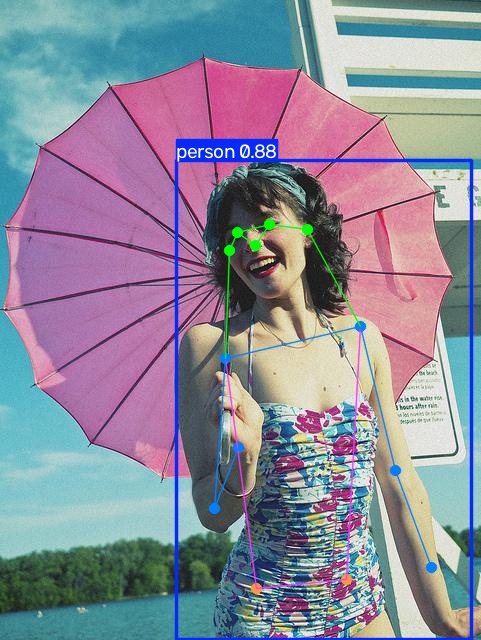
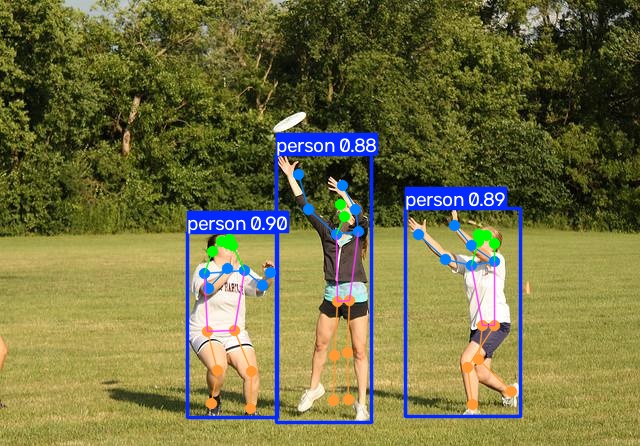
💡 每具人体输出 17 个关键点(鼻子、眼、耳、肩、肘、腕、髋、膝、踝),点连成骨架线。
任务5️⃣ obb 旋转框检测(yolov8n-obb.pt)
yolo predict model=yolov8n-obb.pt source=datasets/dota8/images/val project=runs/obb/runs/demo/05-obb
输出:对 4 张 DOTA8 航拍图全部检出目标(飞机、船、储油罐、棒球场等),输出带角度的旋转框。若把同一模型喂普通街拍图(如 COCO128 的 000000000036),结果为空——obb 是为航拍/俯视场景设计的。
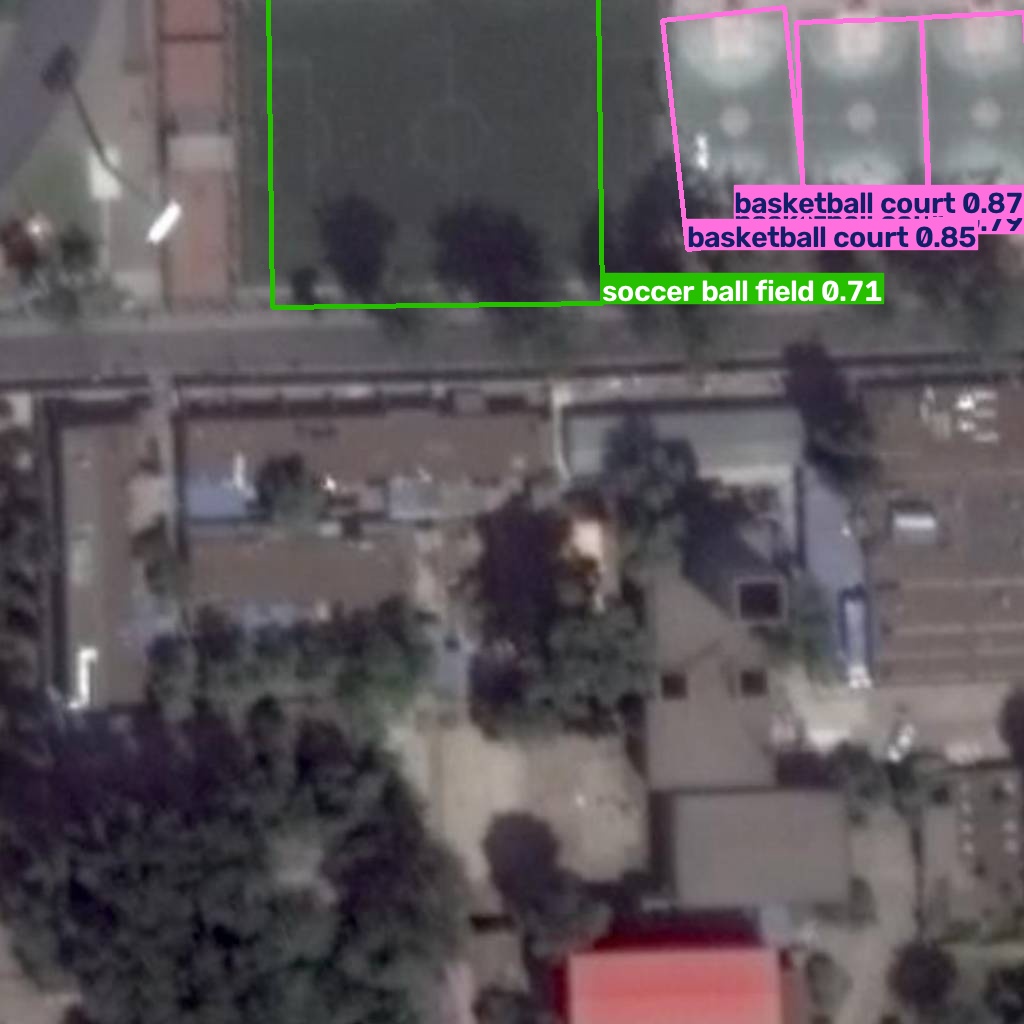
💡 DOTA8 是 DOTA 航拍数据集的最小切片(8 张图),16 个航拍类别:plane、ship、storage tank、harbor、bridge、vehicle、helicopter 等。
四、横评对比表
| 任务 | 模型 | 输入图 | 输出形态 | 结果示例 | 速度 |
|---|---|---|---|---|---|
| ① detect | yolov8n.pt |
鸟图 640x640 | 矩形框 + 类别 + 置信度 | 1 bird | 73.8ms |
| ② classify | yolov8n-cls.pt |
鸟图 224x224 | Top-N 类别概率 | brambling 31% | 14.4ms |
| ③ segment | yolov8n-seg.pt |
鸟图 640x640 | 轮廓像素掩码 | 1 bird | 81.9ms |
| ④ pose | yolov8n-pose.pt |
人体图 640x640 | 17 关键点骨架 | 1~3 person | 47.6ms/张 |
| ⑤ obb | yolov8n-obb.pt |
航拍图 640x640 | 带角度旋转框 | 飞机/船/罐 | — |
⚠️ 速度对比说明:classify 快不只是任务简单,还因为输入图被缩到 224x224(其他任务为 640x640)。同尺寸下排序大致是 classify < detect ≈ pose < segment。
五、实验结论
- 同一张鸟图,三个任务给出三种答案:
- detect → 画框说"这里有一只鸟"
- classify → 不画框,直接说"最可能是燕雀(31%)"
-
segment → 沿轮廓抠出整个鸟的像素区域(掩码)
-
模型只认训练过的类别:pose 只输出 person;obb 只认航拍目标。给模型"没见过"的类别,它宁可什么都不输出,也不会瞎猜一个框。
-
obb 是航拍专属:普通街拍图无输出,换到 DOTA 航拍图立刻检出旋转框——选任务先看场景。
-
任务越精细越慢:classify(14ms)< detect(74ms)≈ pose(48ms)< segment(82ms),精度和计算量成正比。
-
选型落地(呼应潮间带项目):区域/范围识别用 segment,后续结合潮位数据即可做"潮间带范围识别" Demo。
六、后续计划(待办,以后找时间做)
计划 A:视频 / 摄像头实时检测演示
用 yolo predict 或 Python API 对视频流 / 摄像头做实时检测:
# 视频文件(输出带框的预测视频)
yolo predict model=yolov8n.pt source=video.mp4 project=runs/video

# 摄像头(0 号摄像头,实时预览)
yolo predict model=yolov8n.pt source=0 show=True
想验证的点: - 摄像头实时性(CPU 下能到多少 FPS) - 检测框在视频里的连贯性(是否抖动/闪烁) - 结合 track(追踪)让框带 ID 持续锁定目标
计划 B:潮间带范围识别 Demo(segment 方向)
针对潮间带项目,用实例分割做范围识别原型:
- 收集潮间带/海岸线照片(含高潮线、低潮线特征)
- 用 X-AnyLabeling / LabelImg 标注"潮间带"掩码
- 在
yolov8n-seg.pt基础上微调(每类几十张图起步) - 输出"潮间带像素区域",叠加潮位数据计算范围面积
前置参考:海岸线识别与海面分割.md
七、相关资料
- Ultralytics 官方文档 - Predict 模式
- Ultralytics 官方文档 - 任务总览
- 模型权重:官方预训练
yolov8n*.pt系列,见 YOLO简介
📝 创建时间:2026-08-31